ИИ, который отвечает только по вашей базе знаний: проверили на домашнем ПК — 59 верных из 60
Если читать некогда
- Задача
- Клиент хотел разгрузить службу поддержки: на типовые вопросы отвечает ИИ, люди занимаются сложными случаями. Условие — ни вопросы клиентов, ни внутренние инструкции не должны уходить в облако.
- Проверка
- Развернули ИИ на домашнем ПК с игровой видеокартой RTX 4060, без интернета, и задали 70 вопросов по базе знаний:
- две базы — восемь наших внутренних инструкций и 150 статей справки Битрикс24;
- три открытые модели на своём железе и облачный Claude Sonnet 5 для сравнения;
- из 70 вопросов 10 — без ответа в базе: проверяли, начнёт ли модель сочинять;
- все 280 ответов прочитал человек.
- Результат
- Лучшая модель на своём железе — 59 верных ответов из 60, облачный Claude — 60. Выдумок ноль у всех. Единственная ошибка была не в модели, а в поиске: нашёлся не тот абзац.
- Вывод
- ИИ отвечает строго по базе знаний и на своём сервере. Своя модель — это не экономия, а цена конфиденциальности: по деньгам облако выигрывает, пока вопросов не десятки тысяч в месяц.
Что предлагаем: такой же замер на вашей базе знаний до покупки сервера — отчёт с цифрами, где модель ошибается и какой сервер нужен.
Нейросеть может отвечать клиентам и сотрудникам по вашей базе знаний: брать ответ только из ваших инструкций и регламентов, говорить «в базе этого нет» вместо выдумки и работать на вашем сервере, не отправляя ни строчки в облако.
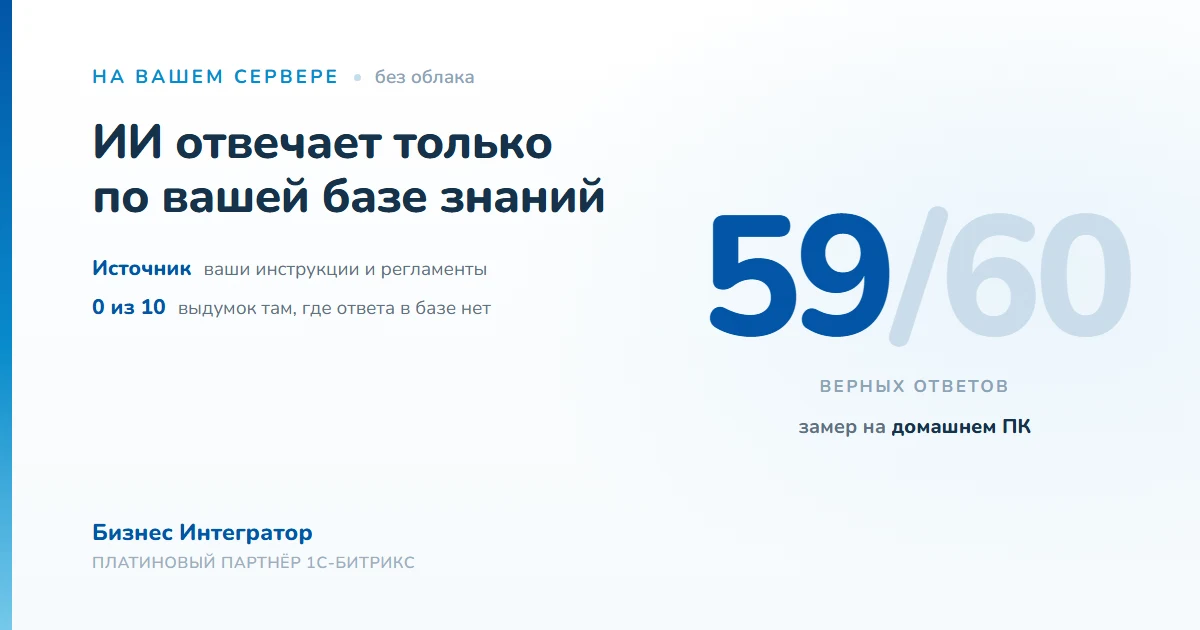
Мы проверили, насколько это надёжно, на самом скромном железе — домашнем компьютере с игровой видеокартой, без интернета. Задали 70 вопросов по базе знаний, из них 10 — таких, ответа на которые в базе нет. На остальные 60 — 59 верных ответов, на 10 «пустых» — ни одной выдумки. Облачный Claude на тех же вопросах ответил верно на все 60.
верных ответов по базе знаний — на домашнем ПК, без интернета
выдумок там, где ответа в базе нет
у облачного Claude Sonnet 5 для сравнения
Домашний ПК здесь — не тема, а нижняя планка: если ИИ держит качество на нём, на сервере компании удержит тем более. Ниже — с чем пришёл клиент, как устроен такой ИИ, как мы проверяли и где подвох.
В конце статьи можно скачать полный отчёт по замеру в PDF: методика, все цифры и ответы моделей на одни и те же вопросы.
С чем пришёл клиент
Компания с собственной службой поддержки хотела разгрузить сотрудников. Есть база знаний: инструкции, ответы на частые вопросы, регламенты. Задача — чтобы на типовые вопросы отвечал ИИ, а люди занимались сложными случаями. С одним условием: ничего не должно уходить в облако — ни вопросы клиентов, ни инструкции компании.
Обычный путь — подключить облачную модель: Claude, GigaChat, YandexGPT. Это дёшево и работает хорошо. Но у этого клиента служба безопасности против: в вопросах клиентов бывают персональные данные, а внутренние инструкции не должны покидать компанию.
Значит, модель должна работать на сервере компании. И сразу появляются вопросы:
- какой сервер для этого нужен и сколько он стоит;
- насколько хуже будут ответы по сравнению с облаком;
- не начнёт ли модель уверенно сочинять.
До этого проекта мы отвечали на такие вопросы по ощущениям. Теперь отвечаем цифрами: собрали стенд, прогнали 70 вопросов через четыре модели и прочитали все 280 ответов.
Как нейросеть отвечает по базе знаний
Частое заблуждение: «чтобы бот знал базу, её нужно целиком отправлять модели с каждым вопросом». Это не так — и в облачном варианте тоже.
Поиск находит в базе 3–6 абзацев, подходящих к вопросу. Модель получает только их и вопрос — и пересказывает найденное человеческим языком.
По шагам:
Статьи режутся на фрагменты по абзацу-два. Для каждого считается «отпечаток смысла» — набор чисел. Всё это хранится на сервере компании.
Считается отпечаток вопроса, из базы достаются ближайшие по смыслу фрагменты. Это примерно полторы страницы текста, а не вся база.
Ответ строится только по найденным фрагментам, со ссылкой на статью, из которой он взят.
Бот не отвечает сам, а передаёт вопрос сотруднику.
Где оказываются данные
| Модель на своём сервере | Облачная модель | |
|---|---|---|
| Нужен ли интернет | Нет: только один раз, чтобы скачать модель | Да, на каждый вопрос |
| Вопрос клиента | Остаётся в компании | Уходит поставщику ИИ |
| База знаний | Остаётся в компании | Целиком — нет, но найденные абзацы уходят с каждым вопросом |
| Что нужно | Сервер с видеокартой | Обычный сервер — для бота и поиска — плюс оплата поставщику за вопросы |
| Если поставщик изменит правила | Ничего не меняется | Может вырасти цена, пропасть модель или доступ из страны |
Как мы проверяли
Железо — домашний компьютер. Обычный ПК с игровой видеокартой RTX 4060 на 8 ГБ, не сервер. Выбрали его намеренно: нам нужна была нижняя планка. Если ИИ справляется на домашнем железе, на сервере он справится точно.
Интернет ему не нужен. Модель скачивается один раз, дальше работает целиком на самом компьютере: вопрос, поиск по базе и ответ не выходят за его пределы. Отключите интернет — ИИ продолжит отвечать всем, кто работает с ним внутри вашей сети.
Модели. Три открытые, которые помещаются на эту видеокарту, и одна облачная для сравнения:
| Модель | Разработчик | Размер | Особенность |
|---|---|---|---|
| Qwen 3.5, 9 млрд параметров | Alibaba | 6,6 ГБ | Целиком на видеокарте, самая быстрая |
| Gemma 4, 12 млрд | 7,2 ГБ | Сжата с учётом будущего сжатия, теряет меньше качества | |
| Gemma 4, 26 млрд | 18 ГБ | «Смесь экспертов»: на каждом шаге работает малая часть модели, поэтому помещается частично на видеокарту, частично в память | |
| Claude Sonnet 5 | Anthropic | облако | Точка отсчёта |
Две базы знаний:
- наша внутренняя — 8 инструкций для сотрудников: доступ к рабочим сервисам, регламент работы с кодом портала, описания наших сервисов;
- 150 публичных статей справки Битрикс24 — телефония, открытые линии, CRM, коробочная версия. Большая и разнородная база, ближе к реальному хэлпдеску.
Вопросы. По 35 на каждую базу, сформулированные так, как спросил бы живой человек. 30 — с ответом в статьях. 5 — таких, ответа на которые в базе нет. Эти пять важнее остальных: они показывают, начнёт ли модель сочинять.
Проверка. Все модели получали одни и те же найденные фрагменты и одну инструкцию. Каждый из 280 ответов прочитан человеком — автоматическая проверка по ключевым словам ошибается в обе стороны.
Что получилось
| Модель | Верно из 60 | Выдумок из 10 | Время ответа |
|---|---|---|---|
| Qwen 3.5, 9 млрд | 55 | 0 | 1,5 с |
| Gemma 4, 12 млрд | 57 | 0 | 4,3 с |
| Gemma 4, 26 млрд | 59 | 0 | 5 с |
| Claude Sonnet 5 | 60 | 0 | 2 с |
И тот случился не из-за модели: поиск нашёл нужную статью, но не тот абзац.
Три вещи, которых мы не ожидали
Формулировка инструкции важнее размера модели. Сначала мы написали строгое «отвечай только по фрагментам, ничего не додумывай». Модели стали перестраховываться: на вопросы вида «можно ли…» до четырёх из тридцати раз отвечали «не знаю», хотя ответ был перед глазами. Одна правка — «если ответ следует из текста, скажи да или нет и поясни» — убрала почти все такие отказы и не добавила ни одной выдумки.
Все оставшиеся ошибки — от поиска, а не от модели. На вопрос «нужно ли платить за SIP-коннектор, если нужны только входящие звонки» ошиблись все три локальные модели. Правильный ответ в статье есть, но нужный абзац не попал в подборку. Локальные модели отказались отвечать или ответили не о том. Облачная честно написала, что прямого ответа в найденном тексте нет, и вывела его из того, что было. Вывод для практики: улучшать нужно прежде всего поиск.
Самая маленькая модель неустойчива на точных строках. В перечне адресов, с которых приходит письмо для восстановления пароля, она в одном прогоне подменила домен, в другом — написала верно. Такая ошибка опаснее отказа: она выглядит уверенно. Для поддержки мы бы её не брали.
Как звучат ответы
Цифры не показывают разницу в тоне. Вот один вопрос и ответы трёх моделей (сокращённо):
Вопрос: «Клиент пишет то во ВКонтакте, то в Telegram, и в CRM появляются две карточки. Как собрать всё в одну?»
- Gemma 4, 12 млрд: можно с помощью чат-трекера — он определяет клиента по контактам и собирает переписку в одну карточку.
- Gemma 4, 26 млрд: то же, плюс точный путь по меню: где включить чат-трекер и какие две галочки поставить.
- Claude Sonnet 5: то же, плюс что делать с уже созданными дублями.
Все три ответа верны. Но для первой линии поддержки последний довесок экономит клиенту второе обращение. Именно в таких «продолжениях» облачная модель пока сильнее.
Сколько стоит корпоративная нейросеть на своём сервере
Сервер для самого бота, базы и поиска нужен в обоих вариантах. Это обычный сервер без видеокарты — аренда от нескольких тысяч рублей в месяц.
Дальше варианты расходятся:
| Своя модель | Облачная модель | |
|---|---|---|
| Доплата | Сервер с видеокартой: аренда 30–50 тыс. ₽ в месяц или покупка 450–700 тыс. ₽ | Оплата за вопросы: порядка 0,3–0,4 ₽ за вопрос |
| Тысяча вопросов в месяц | Те же 30–50 тыс. ₽ | Несколько сотен рублей |
| Обслуживание | Ваше или наше: обновления, сбои | Поставщика |
По деньгам облако выигрывает, пока вопросов не десятки тысяч в месяц.
Чего этот тест не показывает
Честно о границах:
- Крупные открытые модели мы не проверяли. На видеокарту 24–32 ГБ помещаются модели на 27–31 млрд параметров, заметно сильнее наших. Вполне возможно, что на нормальном сервере разрыв с облаком исчезнет. Это следующий замер.
- Базы были аккуратными. В реальном хэлпдеске бывают устаревшие статьи и два разных ответа на один вопрос. Там результат будет ниже у всех моделей, включая облачные.
- Вопросы составляли мы. Живые клиенты пишут путанее, с опечатками и сразу о двух вещах.
- Одна задача. Мы проверяли ответы по базе знаний. На свободном диалоге, переговорах, сложных рассуждениях разрыв между небольшой локальной моделью и облачной будет заметнее.
Когда бизнесу нужна нейросеть без интернета
Главное, что показал замер: ИИ умеет отвечать строго по базе знаний и не сочинять — и в облаке, и на своём железе. Разница между вариантами не в качестве ответов, а в том, где находятся ваши данные и кто обслуживает сервер.
Модель на своём сервере стоит рассматривать, если:
- данные клиентов или внутренние документы нельзя передавать внешним сервисам — по требованию службы безопасности, закона или договора;
- нужна независимость от поставщика ИИ, его цен и доступности из страны;
- вопросов много — десятки тысяч в месяц;
- есть кому обслуживать сервер — или вы готовы отдать это подрядчику.
Если ни одно из этого не про вас — начните с облачной модели. Принцип тот же: ответы только по вашей базе, без выдумок. Это быстрее и дешевле, а перейти на свою модель потом можно без переделки бота: меняется только адрес, куда он отправляет запросы.
Если у вас похожая задача
Мы проведём такой же замер на вашей базе знаний, до покупки сервера:
Берём вашу базу — или её часть — и 30–50 реальных вопросов ваших клиентов;
Прогоняем их через 2–3 подходящие модели и облачную для сравнения;
Отдаём отчёт: сколько ответов верных, где модель ошибается, какой сервер нужен и сколько он будет стоить.
По итогам вы увидите на своих же вопросах, как ИИ отвечает по вашей базе и где ошибается, — и решите, нужна ли своя модель, на фактах, а не на обещаниях.
Методика, все цифры и ответы моделей на одни и те же вопросы — 12 страниц.
Расскажите, какая у вас база знаний и какие вопросы приходят в поддержку. Предложим, как провести такой же замер на ваших данных.